凌晨两点的评审会:人机协同研发到底谁在拍板?
凌晨两点,南京的雨刚停。我盯着一条支付回调接口的 diff,眼皮打架。评审助手突然弹出一行字:可疑,回调重试缺少幂等键。我骂了句脏话——不是气它,是气自己刚才真没看见。
这就是人机协同研发里很具体的一小块:让模型参与研发评审。不是让它替人写代码,也不是让它当最终签字人。它干的是夜班筛子的活。人负责拍板。
别把AI当裁判,它更像值夜班的筛子
评审为什么需要协同?因为人眼在重复模式面前会钝。一个晚上看三百行改动,前一百行还认真,后面就开始“看起来差不多”。模型不困。它能把 diff 切片,扫一遍异常模式:空指针、事务边界、日志脱敏、重试幂等、配置默认值。它也会胡说。对,会胡说。
所以工具链得做三件事:给上下文、给证据、给置信度。上下文不是把整个仓库塞进去,而是把这次改动相关的接口契约、调用链、历史事故工单、测试覆盖拉进来。证据是“哪一行、哪条规则、哪次线上故障”。置信度是让工程师知道该先看哪几条。没有这三样,AI评审就是弹幕,热闹但没用。
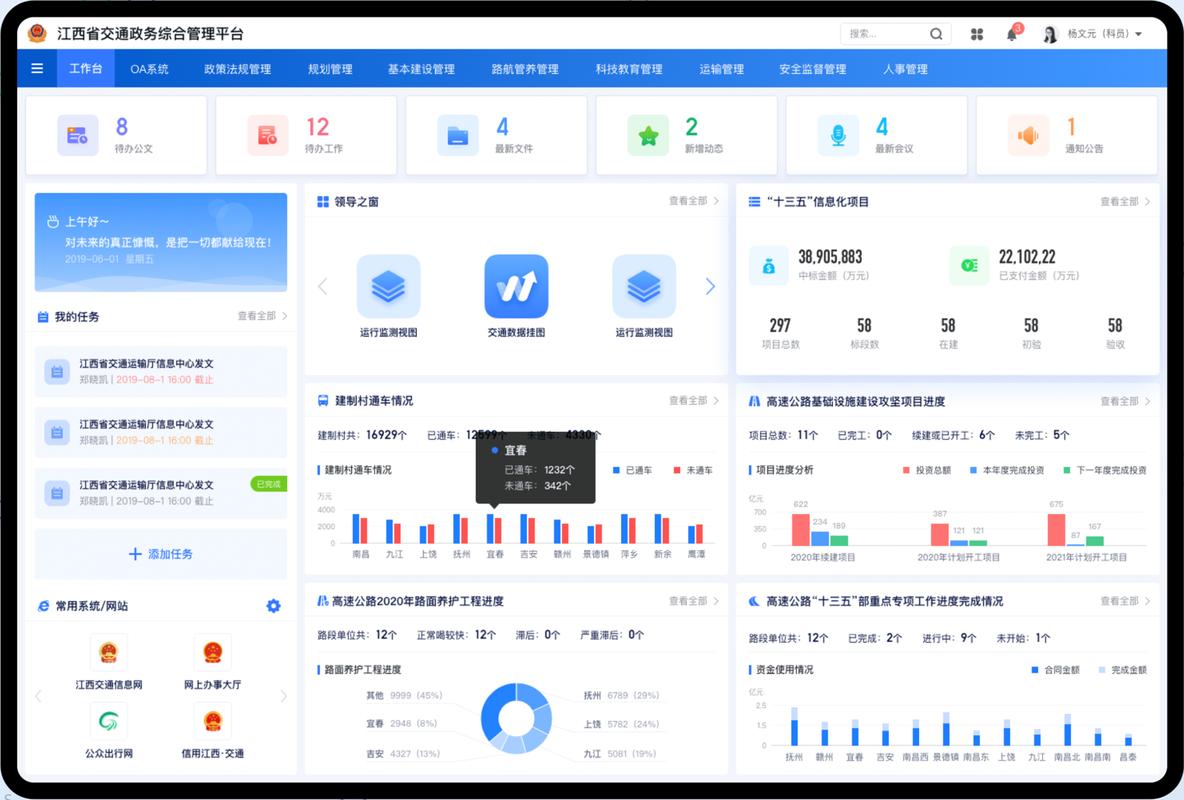 人机协同研发代码评审工作台界面
我拿它当副驾。副驾不抢方向盘,但会提醒“前面路口去年出过事故”。有次它指着一个看似无害的缓存刷新逻辑,说历史工单里同类写法导致过雪崩。我去翻工单,真有。那一刻挺爽。可另一次,它把一段业务上必须的重复扣款补偿标成高危,理由是“重复”。我驳回,写了半行理由:补偿场景允许重复,靠对账兜底。它没再犟。这个驳回理由后来进了团队规则库。
人机协同研发的评审,核心不是模型多聪明,而是把人的注意力省下来,压到真正要拍板的地方。
一条评审意见怎么长出牙齿
光有提示不够。评审意见要能落地,得挂在工作流上。我们的做法很土:diff 进来先切片,按风险打标签;模型只对高风险切片做深看;输出必须带证据链;工程师点“接受、驳回、稍后看”;驳回必须写理由;理由回写规则库和评测集。听着像流程官僚?可没有这个闭环,AI评审就是一次性烟花。
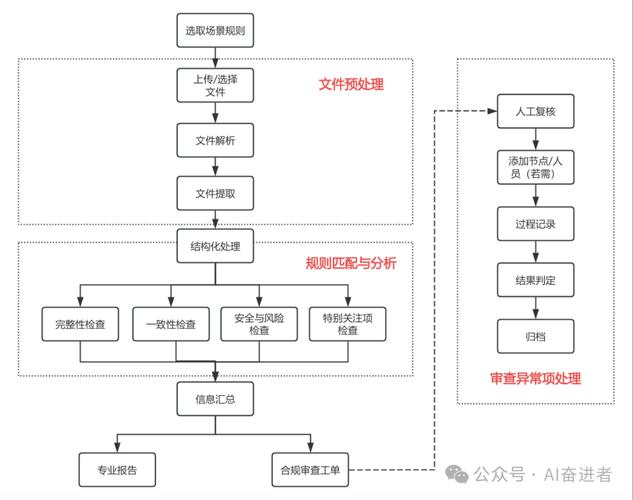 人机协同研发评审意见证据链流程图
举个真事。一个订单状态机改动,模型提示“状态回退缺少审计日志”。证据指向半年前一张工单。工程师起初嫌烦,说状态回退一天没几次。后来安全同学加入评审,直接拍板加日志。不是模型赢了,是证据把讨论从“我觉得”拉到“出过事”。这就是协同。模型提供线索,人提供业务权重和责任。
还有个细节:别让模型直接改代码。至少评审阶段别。它一改,工程师容易从“评审者”滑成“看结果的人”。看结果很轻松,但责任也滑走了。我们只让它给建议补丁,不进主干。补丁要人点,提交信息要人写。签字的是人,留痕的是证据,这条线不能糊。
工具链里还有个脏活:误报治理。早期模型爱报“可能的空指针”,一天几十条,工程师开始无脑点忽略。评审疲劳会把信任耗光。后来我们按模块统计接受率,误报高的规则先降噪,或者只在高风险变更里开。别追求全量覆盖。全量覆盖听着漂亮,实际会把信任耗光。
哪些地方别让模型抢方向盘
 哪些地方别让模型抢方向盘
边界得说清楚。模型擅长找“像曾经出过事的模式”,不擅长定“这次业务要不要冒这个险”。支付、医疗、车控这类高风险变更,模型可以提示,不能放行。上下文缺失时别硬上。一个只看到 diff 的模型,像只看到病历最后一页的医生,容易下猛药。
风险还有几个。知识泄漏:把敏感代码和工单喂给外部模型前,得脱敏、得看合同。责任归属:模型建议导致事故,锅不能甩给“算法”。组织学习:如果团队习惯了点“通过”,久了就没人读代码,模型一漂移,整条防线塌。还有模型漂移本身——供应商升级一版,行为就变,评测集得跟着跑。
常见误解也得拆。AI评审不等于自动质量。它只是把可疑点往前挪。模型参数多不等于懂业务。评审助手的价值不在“替人判断”,在“让人看到该判断的地方”。
凌晨两点半,我把幂等键补上,顺手驳回了模型两条过度报警。窗外南京的雨又下了。人机协同研发没那么玄,它像老钳工带徒弟:徒弟眼尖,师傅手稳。谁拍板?人。可没有那双夜班的眼睛,人也会漏。