技术复盘方法:别把科研失败写成悼词
上周旁听一个科研组复盘。投影仪上一条漂亮折线。结论四个字:效果未达预期。我差点把咖啡喷出来。这哪叫复盘——这是给失败做遗体告别。
技术复盘方法的核心不是解释过去,是提高下一次实验的胜率。科研场景更狠:一次失败可能烧掉半年,数据噪声大,审稿人还盯着你能不能复现。对吧,光说“辛苦了”没用。
先把时间线钉在墙上,别写流水账
复盘第一步,拉时间线。不是“1月跑数据、2月训模型”这种流水账。要标决策点:哪天改了损失函数,谁拍的板,当时相信什么,证据有多硬,代价多大。每个决策点后面必须跟一行:当时的假设、观察到的证据、缺席的证据。缺证据的地方,往往就是坑。
说实话,很多团队复盘只盯最终指标。指标掉了,大家开始猜。猜数据、猜代码、猜算力。猜到最后变成玄学。别这样。把实验记录、代码提交、数据版本、会议纪要摊在一张桌上。时间线一拉,因果链就露头。
 科研实验室白板复盘决策时间线
把假设和证据拆开审,像审稿人审自己
科研里最贵的不是算力,是错误假设。复盘时拿一张纸,把结论改写成可检验句:如果A成立,应该观察到B;如果B没出现,是A错了,还是测量错了?这一步很枯燥。但值。
看三样东西:对照是否干净、混淆变量是否被控制、统计功效够不够。机器学习实验再加三样:数据泄漏、预处理口径、随机种子。模型指标突然变好,先别庆祝。查数据切分。指标突然变差,别急着换模型。查标注规则有没有改。行业里现在推模型卡、数据卡、可复现仓库,不是形式主义。复盘时你就知道,缺一行版本号,能让人多熬两周。
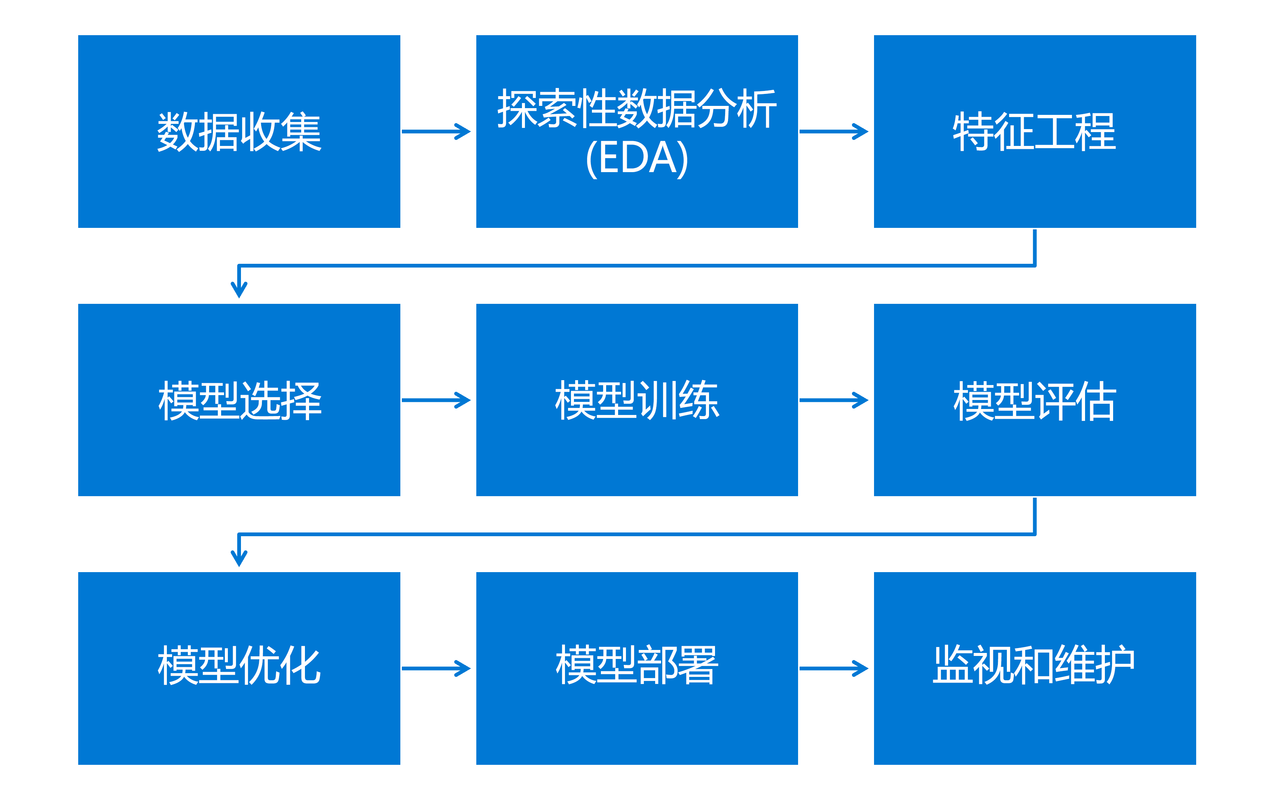 机器学习实验数据版本追踪流程图
归因要分层,别把所有锅甩给算力
 归因要分层,别把所有锅甩给算力
我见过太多复盘会,最后结论是“算力不够”。这话有时对。多数时候是偷懒。把失败拆四层:数据层、方法层、工程层、协作层。数据层问口径和覆盖;方法层问假设和基线;工程层问依赖锁定、非确定性、环境差异;协作层问交接和评审。每层挑一个最可能的故障点,写证据。别开地图炮。
失败也分类:猜想错、测量错、执行错、沟通错。分类不是贴标签,是决定行动项。猜想错就补先验实验;测量错就改评估协议;执行错就加自动化检查;沟通错就把接口写死。混在一起,复盘就变成情绪发泄。对了,阴性结果别扔。科研里阴性结果经常比阳性结果更诚实。建个失败案例库,比堆十篇成功学有用。
反事实推演,找杠杆点,不找后悔药
问三个问题:如果早两周停掉这条路,会怎样?如果换一个基线,结论还成立吗?如果增加一个阴性对照,最可能推翻什么?这不是后悔。是找杠杆点。科研项目最怕在低信息量路线上反复烧钱。反事实推演能把“继续/停止”的阈值提前写出来。
行动项要可验证。别写“加强沟通”“优化流程”。写具体:下周三前把数据版本号写进实验记录模板,缺一项不允许启动训练;下次组会前补三个基线,结果贴进复盘文档;模型上线前跑一遍可复现脚本,随机种子固定三次。行动项别超过五条。多了没人做。真的。
复盘会怎么开,决定复盘是不是表演
先放事实,再放情绪。主持人先自曝一个失误,别一上来抓典型。白板画时间线,每人写“我当时的判断和证据”,沉默三分钟再说话。禁止用“我觉得”替代证据。也禁止人身攻击。科研团队尤其要保护说真话的人。否则下次没人敢说“我早就觉得数据有问题”。那复盘就完了。
工具能用,但别把工具当复盘。MLflow、W&B、DVC能记参数和版本,记不了因果。看板很漂亮,漂亮不等于想清楚了。复盘文档最后要沉淀成三样东西:失败案例库、检查清单、实验模板。下次实验前强制读十分钟。别写悼词。写施工图。