别再把数据往云上送了:边缘计算技术是怎么在车间里救回一条命的
去年秋天,我在南京江宁一家做精密齿轮的厂子里蹲了三天。车间主任老张拉着我看他的宝贝产线——二十台加工中心,每台头顶一个工业相机,拍齿面,把图片传给云端AI做缺陷检测。听起来挺唬人吧?问题出在传输上。厂区Wi-Fi信号在机床之间忽强忽弱,一张图传上去要三到五秒,云端返回结果再等两秒。七秒的延迟,对于每分钟出六个件的节拍来说,等于白干。漏检的次品混进装配线,下游客户直接退货。老张骂骂咧咧:“花了几十万上云,结果不如老师傅拿放大镜瞅一眼。”
你猜后来怎么着?他们没换云,也没换AI模型。只是在每台机床旁边塞了一个巴掌大的铁盒子,把推理这件事从云端拽回了车间。延迟从七秒降到了八十毫秒。那个铁盒子干的事,就叫边缘计算技术。别急着搜定义,我跟你聊点实在的。
先说清楚:边缘计算技术不是“迷你云”
很多人一听边缘计算,脑子里冒出来的画面是:在本地放一台小服务器,把云上的活搬下来跑。这个理解对了一半,但会把你带沟里。云的计算模型是“你送数据过来,我算完还给你”。边缘计算的逻辑是“数据别动,我过去算”。核心差异不在硬件大小,在数据流动方向。
打个比方。你家楼下有个菜鸟驿站,你网购的包裹从杭州分拨中心发到南京转运中心,再发到小区驿站。最后一公里你自己去取。转运中心就是云,驿站就是边缘。如果你非要每个包裹都去杭州分拨中心自提,那就是老张厂子最初的方案——路费比货贵,时间全耗在路上。
用技术语言说:边缘计算技术把计算能力下沉到数据产生的地方、或者紧挨着数据产生的地方。工厂车间、路侧灯杆、商场摄像头、甚至你家的路由器。下沉的不是完整的云服务,而是特定的一类任务——实时推理、协议转换、数据过滤、轻量级控制。比如老张的齿轮缺陷检测,模型早就训练好了,云端只负责定期更新模型权重,推理那一哆嗦,边缘盒子自己扛。
 工业车间边缘计算网关部署实景图
第一回听到“边缘计算”四个字是2016年左右,当时我在搞视频监控项目。客户要求把十路摄像头的车牌识别放在本地,云上只存结构化结果。我第一反应是“神经病吧?云上GPU那么便宜”。后来一算账:十路高清视频流全传云端,一个月带宽费八千多,还不算存储。本地搞个带NPU的小盒子,两千块,一次性投入。客户是对的。带宽和延迟这两笔账,经常比算力本身贵得多。这也是边缘计算技术从“概念”变成“刚需”的底层原因——不是技术多炫,是经济账算得过来了。
它到底怎么运作的?拆开那个铁盒子给你看
老张车间里那个盒子,我撬开看过(别学我,保修没了)。里面没有风扇,一块ARM板,一颗算力大概几个TOPS的NPU,跑着裁剪过的TensorFlow Lite。软件栈分三层:底层是设备接入,支持相机走RTSP、PLC走Modbus、传感器走MQTT;中间层是推理引擎,负责加载云端下发的模型文件;上层是业务逻辑,比如“检测到缺陷就触发气动推杆把零件踢进废品槽”。
整个链路里最不起眼但最要命的一环是模型下发。你在云端用PyTorch训练好一个缺陷检测模型,直接扔给边缘盒子,它大概率跑不动——算子不支持、内存爆了、精度掉得亲妈都不认识。所以中间要有一步:模型转换和量化。把32位浮点权重压成8位整数,精度损失控制在1%以内,体积缩小四分之三。这活儿干过的都知道,调量化参数比调模型结构还磨人。有次为了把YOLOv5塞进一个内存只有512M的盒子,我熬了两个通宵,最后发现是某个注意力模块的中间张量没释放。说出来都是泪。
不过话说回来,边缘计算技术里最反直觉的一点:边缘节点通常不是孤岛。它得跟云端保持心跳,定期拉取新模型、上报运行日志、同步异常样本。我见过一些方案吹“完全离线”,那是唬人的。真离线了,模型退化了你都不知道。比较好的做法是“边缘推理,云端训练,模型双向流动”。云端像个班主任,定期给各个边缘节点发新教案;边缘节点像课代表,把学生不会的题(难样本)传回去。
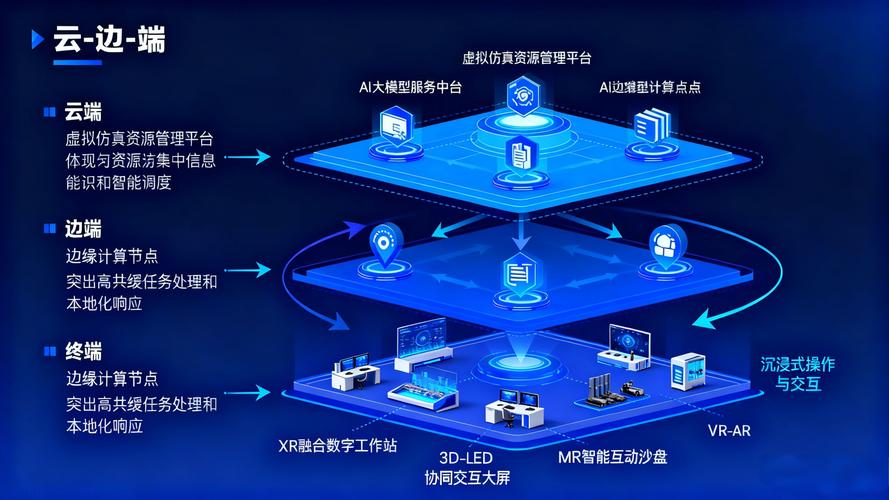 边缘计算模型量化与云端协同架构示意图
再说个具体的。自动驾驶为什么离不开边缘计算技术?你想想,激光雷达一秒出几十万个点云,摄像头一秒三十帧图像,全传到云端再决策?等云端算完,车早撞上了。所以必须车端本地算——车本身就是一个移动的边缘节点。但车端算力有限,复杂场景(比如没见过的施工路段)拿不准怎么办?上传到路侧边缘服务器(就是那个带计算单元的智能灯杆),路侧再拿不准才回传云端。这叫“车-路-云”三级架构。你品品,每一级都在解决上一级搞不定的延迟和带宽。
用在哪、别用在哪:几个真实的踩坑记录
 用在哪、别用在哪:几个真实的踩坑记录
智能制造是最先跑通的场景。老张那个齿轮检测只是冰山一角。我见过一个做液晶面板的厂子,用边缘计算技术做屏幕缺陷检测——每个工位一个边缘盒子,拍照、推理、分拣全在本地完成,产线节拍从每分钟12片提到18片。关键就一条:省掉了图片上传下载的往返时间。还有个炼钢厂,高炉温度预测,传感器每毫秒出一次数据,云端根本来不及收。边缘节点直接跑轻量级LSTM,预测下一分钟的温度趋势,超阈值就报警。这玩意儿救过一次炉子——提前四秒预警,工人紧急停料,避免了一次可能几十万的设备损坏。
智慧零售里也用得不少。你进便利店看到的那个自助结账摄像头,识别商品靠的就是边缘盒子。为什么不用云?因为顾客扫码到支付完成也就两三秒,如果云端排队,后面的人能骂街。还有商场的人流热力图,边缘端直接统计人数和轨迹,只把计数结果传云端。原始视频?本地存七天,过期删除。省带宽、省存储、还合规。说到合规,这是个容易被忽略的甜头。人脸识别数据不上云,隐私风险小一半。
但边缘计算技术不是万能膏药。我踩过的坑,拎两个出来:
坑一:别拿边缘跑训练。有人想在车间盒子上做增量学习,让模型自动适应新出现的缺陷类型。想法很美。实际呢?一个盒子同时服务八个工位,推理已经把算力吃到80%,再加训练,直接卡死。就算用联邦学习,通信开销和模型聚合的复杂度也够喝一壶。目前靠谱的做法还是:边缘只做推理,训练乖乖回云端。
坑二:别忽略运维成本。你以为把盒子装上去就完事了?一个中型工厂两百个边缘节点,分布在不同车间,型号五花八门,固件版本各不同。有一次半夜两点,产线停了,原因是某个盒子因为内存泄漏重启后,容器没自动拉起。我爬起来远程连上去,发现是systemd配置写错了。那瞬间真想砸键盘。边缘节点的运维复杂度,随节点数量指数级上升。所以现在做方案,我第一件事就是问:有没有统一的设备管理平台?没有?那先别铺量。
还有个常见的误解得澄清:边缘计算不是取代云,是给云打下手。有人一听“边缘”就觉得以后云没人用了。胡扯。模型训练、大数据分析、历史归档、跨厂区协同,这些活边缘节点干不了也干不好。云和边缘的关系,更像总部和分公司——分公司有财务审批权,但年度预算和战略规划还得总部做。
最后一个风险:你以为安全了,其实换个地方裸奔
 最后一个风险:你以为安全了,其实换个地方裸奔
说到局限,安全问题是绕不开的坎。很多人觉得数据不上云就安全了——太天真。边缘节点通常部署在物理上可接触的地方,工厂车间、路边灯杆、商场角落。攻击者可以物理拆机、可以插网线、可以短接调试口。我做过一次渗透测试,用一条五块钱的USB转TTL线,撬开一个边缘网关的盖板,两分钟拿到root shell。里面的模型文件和证书全裸。更别说很多边缘盒子出厂默认密码是admin/admin,装完就忘了改。
还有一个隐蔽的风险:模型投毒。边缘节点会定期从云端拉新模型。如果攻击者劫持了更新通道,下发一个“把次品判为合格”的模型,产线全乱套。这事没被大规模报道过,但理论上是通的。目前业界的应对方法是模型签名+差分隐私+异常检测。说白了,你花多少心思防云端被入侵,就该花同等心思防边缘节点被策反。
行了,聊到这儿差不多了。老张那厂子现在跑得挺安稳,去年底扩产,又添了十台机床,边缘盒子跟着加。他前几天给我发微信:“兄弟,那个盒子能不能顺便把我车间的温湿度也监控了?”你看,需求永远比方案跑得快。边缘计算技术不是什么高深玄学,它就是被延迟、带宽和成本这三条鞭子抽出来的务实选择。下次再有人跟你吹“万物上云”,你就问他:数据从车间到云端打个来回,够不够你泡杯茶? 够的话,上云没毛病。不够?那老实蹲边上去。