质量功能展开:当用户声音被压缩成矩阵,失真从哪开始?
你见过那种填满整面墙的质量屋吗?我见过。三米宽的牛皮纸上,客户需求列了四十七行,工程特性写了六十三列,关系矩阵里的符号密密麻麻像暴雨前的蚂蚁窝。项目经理拍着胸脯说这是“质量功能展开的完整落地”。三个月后产品上市,客户投诉最多的问题恰好是矩阵里被标为“弱相关”的那条需求。这很尴尬。不是段子。我在两家制造企业亲眼撞见。
质量功能展开(QFD)的本质是一场翻译——把用户嘴里模糊的、感性的、甚至互相矛盾的话,翻译成工程师看得懂的参数和公差。翻译就有损耗。问题在于,很多团队把矩阵填完就当成了终点,却忘了翻译过程中每一层都在丢东西。
需求收集那一步,噪声已经混进来了
QFD的第一块砖是“客户需求”。但谁来定义客户?我见过一个做工业泵的项目,市场部找了二十个经销商填问卷,得出的需求列表里“运行安静”排在前三。后来现场走访发现,真正的终端用户是车间工人,他们最烦的是泵体发热烫腿。经销商关心的“安静”其实是自家门店演示时的体面。你看,需求源头就偏了。质量功能展开再精密,也救不了从一开始就采错的样本。
更常见的是颗粒度失控。比如“操作简便”这种需求,有的团队直接原样写进矩阵,然后让工程师去猜——是减少按键?还是增大字体?还是加语音提示?猜错了,后面的关系矩阵全是自嗨。我在一个医疗设备项目里见过更离谱的:需求列表里写着“符合人机工程学”,结果工程特性那一栏对应的是“外壳圆弧半径”。圆角半径当然影响手感,但把人机工程学压缩成一个半径数值,这已经不是翻译,是阉割。
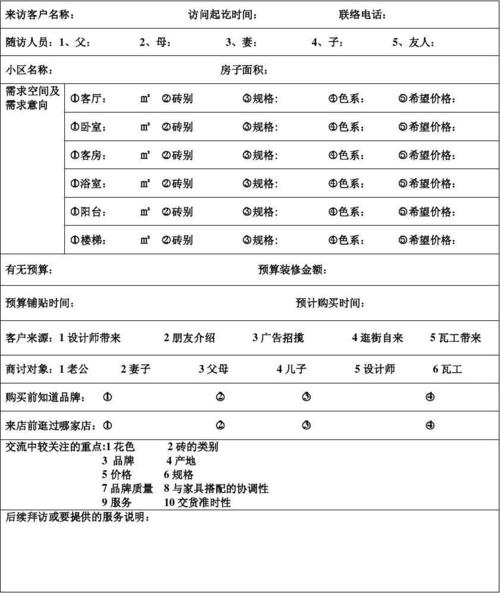 客户需求访谈记录与QFD质量屋工作表对照照片
话说回来,也不是没有补救办法。有些团队会先用亲和图(KJ法)把原始语句聚类,再让用户自己投票选出“如果只能解决三个,你选哪三个”。这一步能砍掉大量伪需求。但代价是时间——QFD本来就重,再加一轮用户工作坊,项目周期直接拉长两周。很多管理者在这个节点上选择了跳过。跳过之后,矩阵照样漂亮,就是不准。
关系矩阵:专家打分还是集体幻觉?
质量屋的核心是那个大矩阵——行是需求,列是工程特性,交叉点填强相关、中等相关、弱相关。教科书上说由跨职能团队集体讨论决定。实操中呢?我参加过一次评审会,市场部说“需求A和特性X强相关”,研发部说“也就弱相关吧”,两边僵了十分钟,最后项目经理拍板:“填中等。”你看,所谓关系强度,很多时候是会议室里的权力平衡产物,不是物理规律。
更隐蔽的问题是独立性假设。QFD默认各个工程特性可以独立优化,但现实中它们往往互相拉扯。比如你想提高泵的流量(特性1),振动(特性2)就会恶化;你想降低噪声(特性3),重量(特性4)就得增加。质量功能展开的关系矩阵只告诉你“需求与特性的关联”,却不告诉你“特性与特性之间的冲突”。这就好比给你一张地图,标了目的地,却没标路上的断桥。
有个做汽车空调压缩机的团队试过打补丁:在质量屋旁边加一个“特性冲突矩阵”,用田口方法的交互作用表来填。效果不错,但矩阵数量翻倍,评审时间从半天变成两天。小项目根本扛不住。所以我的观察是:QFD适合那些需求相对稳定、工程特性数量可控(比如不超过三十个)的硬件产品。软件迭代?算了吧。两周一个 sprint,你连质量屋的墙纸都还没贴完,需求已经改了三版。
 制造业质量屋矩阵关系图手绘示例及特性冲突标注
权重分配:数字的精确掩盖了判断的粗糙
 权重分配:数字的精确掩盖了判断的粗糙
客户需求要加权,工程特性也要算优先级。大多数QFD模板让你用1-5分打分,然后加权求和。数字一出来,大家就当真了。我见过一份报告,某需求权重4.7,另一条4.3,团队据此砍掉了后者。但说实话,让同一个人隔一周再打一次分,4.7可能变成4.2。这种“伪精确”比模糊更危险——它给了决策者一个看似客观的借口。
比较靠谱的做法是成对比较(AHP的简化版),但工作量巨大。n个需求要比n(n-1)/2次。二十个需求就是190次比较。谁有耐心?于是大家又退回到直接打分。循环。
还有一个被忽视的点:权重应该随产品生命周期变化。新品上市初期,“功能新颖”权重大;成熟期,“可靠性”权重大。但很多团队做一次QFD就锁死了权重,后面几年都不改。这就像用去年的天气预报决定今天穿什么。不过话说回来,能坚持每年重做一次QFD的企业已经算勤快的了。更多的是一锤子买卖——项目验收时把质量屋裱起来挂墙上,再也没人翻。
那到底该怎么用?三条带条件的建议
 那到底该怎么用?三条带条件的建议
第一,把QFD当对话工具,别当计算工具。矩阵填得再满,不如让研发和市场坐在一张桌子上吵两个小时。吵出来的共识比加权求和靠谱。我见过一个团队故意不填数值,只用颜色标注“强/中/弱”,然后逼着每个颜色的格子都说出一个具体场景。效果反而好。
第二,只对“高风险需求”做完整QFD。别把四十条需求全塞进矩阵。挑出客户最在意、技术最不确定的那五到八条,做深度展开。剩下的用检查表或DFMEA覆盖。这样既保留了QFD的结构化优势,又不至于被文档压死。
第三,在质量屋旁边加一列“验证方法”。每一条强相关关系,必须对应一个可执行的测试或仿真。填不出来?说明那个“强相关”是拍脑袋的。这个简单的约束能过滤掉大量水分。
至于趋势,数字化QFD工具确实在降低填表负担,但别指望工具能解决判断问题。工具只会让错误的矩阵看起来更漂亮。风险呢?最大的风险是形式主义——质量屋变成给审核看的道具,而不是给工程师用的地图。一旦团队发现填矩阵只是为了应付流程,QFD就死了。
说到底,质量功能展开是一面镜子。它照出的不是客户的声音,而是组织内部的沟通质量。矩阵失真的地方,往往就是部门墙最厚的地方。修矩阵之前,先修墙。